AI科研
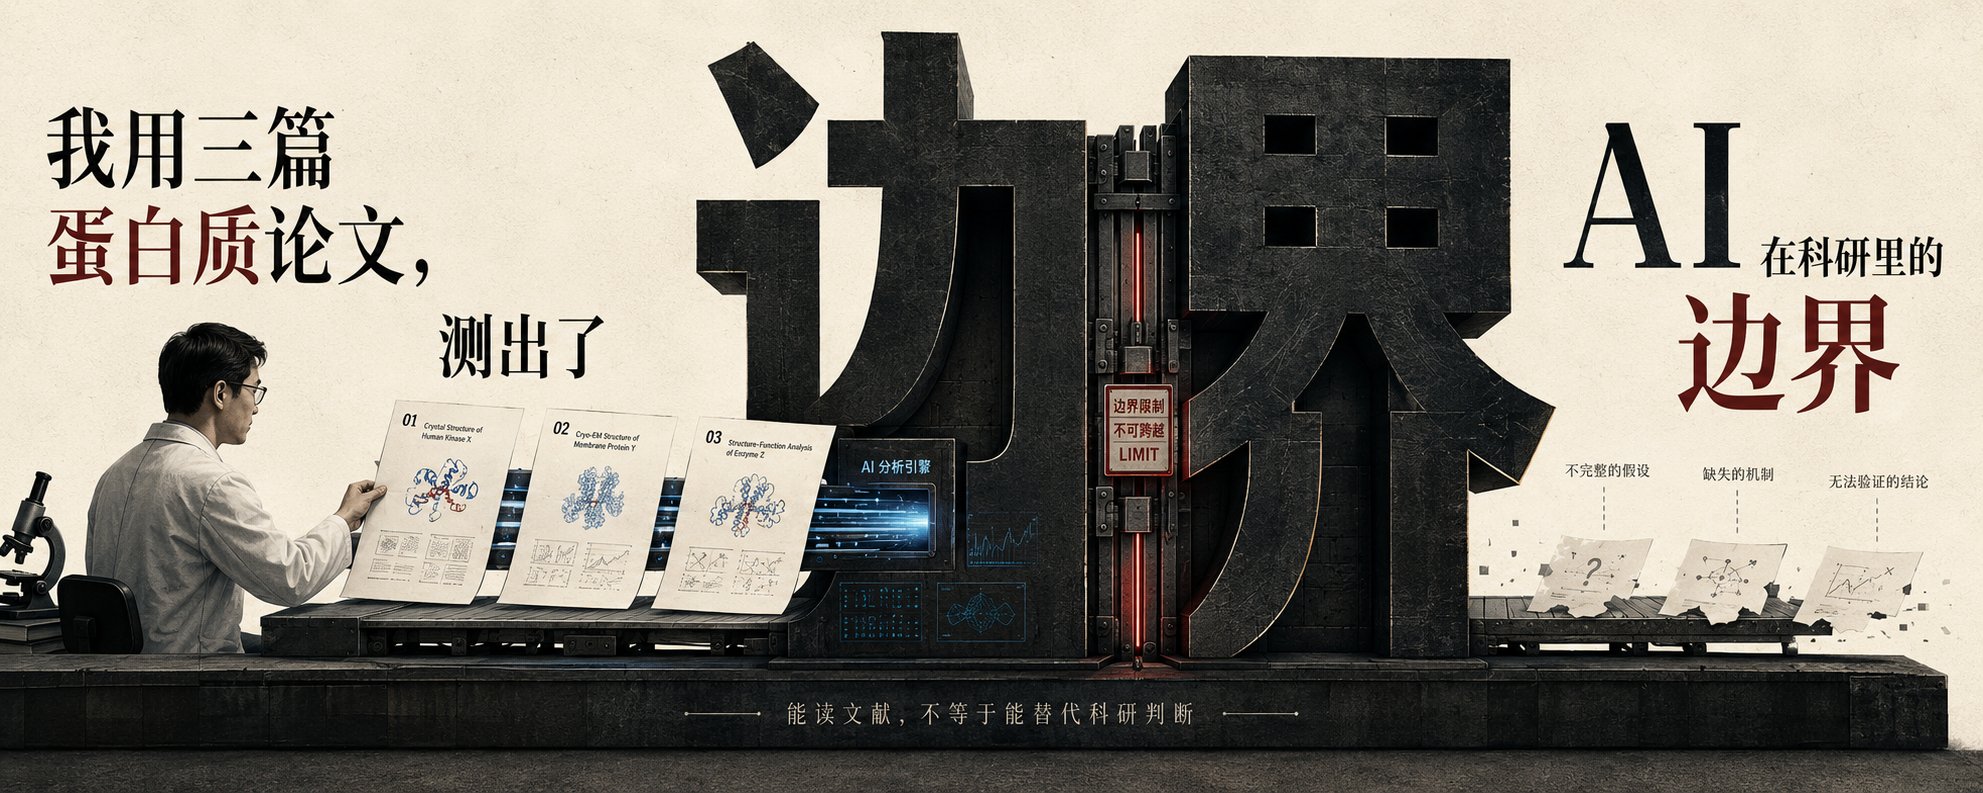
我用三篇蛋白质论文,测出了 AI 在科研里的边界
我用三篇蛋白质论文,测出了 AI 在科研里的边界
这俩天,我做了一件事,想搞清楚 AI 在科研里到底能干到哪一步。
我跟AI最严厉的父亲,先拿三篇蛋白质论文练手,那是个我并不熟的领域。选它有一个原因,蛋白质这块有现成的客观真值,叫 ClinVar,是一个公开的数据库,里面记着哪些基因突变会致病、哪些不会致病,都是医学界一条条核实过的。
有了它,一个 AI 跑出来的预测对不对,可以直接拿去比,对就是对,错就是错,不用人去判。这种地方最适合看 AI 能跑到哪。
练完手,我再把同一套方法搬回自己的主场,卫生经济学。我正在做一篇要投稿的系统综述,。系统综述就是把一个问题底下所有相关研究全找出来、一篇篇读、再合起来下结论的那种研究。这个领域没有现成真值,哪篇研究算数、哪个数字可信,全得人来判。
两边一对照,AI 的边界就出来了。
把整套科研流程拆开看,每个环节落到三类里。第一类,AI 可以直接替人做,做得跟人一样好甚至更好。第二类,AI 能做出东西来,但必须有个人独立复核一遍才算数。第三类,AI 根本做不了,不是它现在能力不够,是这件事的性质决定了它做不了。
第一类:AI 直接顶替人
这一类的共同点是,有客观标准可以对照,或者本身就是规整的体力活。
模型推理和数值计算,AI 完全顶替。三篇蛋白论文,一篇要跑 1444 个突变,一篇 801 个,一篇 795 个,全部算完,中间没断过。bootstrap 重采样跑 2000 次拿置信区间,DeLong 检验、Brier 分数、AUROC、AUPRC 这些指标全自动算出来,数值彼此对得上。蛋白那篇试了 5 种配置,增量那篇试了 4 个工具的梯度,全跑通了,每个配置还记下了耗时和显存,比如 11.3 秒、2.69 GB。这层是纯计算,有数学定义的标准,人在这儿加不了任何东西。
文献检索的执行,基本顶替,人审一遍逻辑就行。综述的 PubMed 检索式,AI 搭了 MeSH 加 tiab 两条轨,把概念词,跟经济评价那一组概念词用 AND 连起来。一开始命中 4724 篇,AI 把杂音的词砍掉,收紧到 271 篇。这里唯一要人做的,是审一遍这套检索逻辑站不站得住。
结构化抽取,可以顶替,但要抽查。我让 AI 把每篇研究里怎么处理采纳率这件事,按八个维度抽出来,从用的什么词、怎么定义、用什么函数形式,一直到这个参数变动会不会影响结论。30 篇全文抽进一张表,每篇 13 个字段,数字一个个照原文抄,盖了 16 个国家和地区。填得对不对,得人去抽查。
引用核查和格式,这是 AI 最绝的,比人可靠。每条引用都带 DOI 和 PMID。核不实的,它明明白白标上 COULD NOT VERIFY,比如某篇印尼研究作者的全名、某个试验里的依从率数字、某篇文献正文的具体措辞,它够不到的就老实说够不到。
它还抓到了真错误,某篇文章我原稿写成 25128043,正确的是 25128044,差一位数就会指到一篇毫不相干的论文上去。它也抓到了原文自己打架的地方,某篇文章研究里 91.9% 和 91.7% 两个数对不上。主动暴露自己不确定,再精确地指出错在哪,这件事它做得比人更好,更准确,也更省力。
归纳综合,可以顶替,但怎么分要人来拍板。AI 从 30 篇里归纳出采纳率的六种类型,看完我也在感慨,这是真的综合,不是简简单单地把摘要拼一起。它还正确地把试验内部那种实测出来的采纳率单独切了出来。
论文写作,AI 写得成熟,超过大多数人。四篇里语言、结构、图表说明、段落之间怎么过渡,都专业。这恰恰是个陷阱,后面再说。
第二类:AI 能做,人复核才算数
这一类,AI 能产出结果,但这个结果合不合法,得靠一个独立的人脑去核验。
第一个是文献筛选。271 篇标题摘要,我开了 4 个 AI 在那儿并行筛,AI 自己很诚实地标注,这等于一个单评审加上机器内部的一致性。这里有个话术上的坑,叫“四路并行等于机器一致性”,听着像交叉验证,其实不是。四个同源的 AI 筛出来一致,只能说明它判断稳定,不能说明它判断正确。它们是同一个脑子的四个副本,共用同一套盲点。越一致越唬人。系统综述要算数,评审者之间的信度必须是两个不一样的脑子之间的,人跟 AI,或者两个不同的人。这一条不补上,方法学上这就还不算一篇真正的系统综述。该人做的是,找第二个评审独立再筛一遍,至少复筛 20%。
第二个是付费墙后面的全文。45 篇里我够到了 30 篇全文,那是开放获取的那部分。13 篇锁在付费墙后,2 篇只有摘要,AI 抓不到。这是一堵物理的墙。
更要命的是偏倚,能免费拿到的那批,可能系统性地偏向某一类研究。几篇早期的、压在老牌期刊后面的经济评价正好都在墙后。拿一个有偏的子集,去下“30 篇全是外生处理”这种全称结论,逻辑上是悬空的。该人做的是,用我的机构权限手动把那 13 篇 PDF 取下来,补全抽取。
第三个,是抽取判定的证伪。有些判定不是照抄,是 AI 在解读。比如有一篇,AI 自己标注说,它判这篇是“隐含 100% 覆盖”,是推断出来的,从“全文没有一行讲实际使用率,而效果施加在全队列上”推过去的。“30 篇全是外生”这个结论干净得有点可疑,真实文献很少这么整齐。要警惕的是,会不会是那张抽取表本身的设计,把所有模糊的案例都往“外生”这一栏归了。该人做的,是亲自抽 5 篇全文去证伪这个结论,不是去确认它。
第四个,是核心论断往哪个方向收紧。这里 AI 做了件超出我预期的事,它推翻了我自己原稿的论断,而且它是对的。我原稿写采纳率“从不进敏感性分析”“一直隐形”,AI 核查完,直截了当说这话站不住,审稿人一眼就能驳倒,因为有几篇研究确实在单向敏感性分析里变动过覆盖率。它给了我一个更准的说法,分两段,一是外生从不转内生,二是就算变动也只是粗暴的单向变动,这个参数对决策到底有多大影响,从来没真正检验过。它没有顺着我的假设去找支持的证据,它用实证反驳了作为作者的我。但论断最终往哪个方向收,这是我的研究判断。它给方案,我拍板。
第三类:AI 根本做不了
这一类,就算 AI 的能力再强十倍也做不了。因为这些事的本质,需要一个有身份、能负责、能独立验证的人。这一类是这篇文章里我最想讲清楚的。
第一件做不了的事,是提出对的问题。
四篇论文价值差多少,几乎全由问题怎么定决定,而问题全是我定的。一篇关于 ubiquitin,问题问得差,我问的是 ESM-2 这个模型能不能找到功能位点,这是个无聊问题,早有人做过,我还硬套了一个名不副实的概念上去,那篇质量分只有 30 到 35,落在最差的那档期刊区间。另外一篇关于 DEE 增量,问题问得好,我问的是大模型相对于纯保守性的方法,到底多带来了多少增量价值。同样的数据,同样的算力,换了个问题,价值翻倍,质量逼近顶级期刊区间。
综述里最值钱的那个问题,是我定的,不是 AI 定的。那个问题是,所有人都默认采纳率这个参数是外生的、是从别处借来不加检验的,这件事本身就值得质疑。AI 在给定问题底下能飞快地跑,但它不会自己冒出这个念头,意识到“全行业的人都没质疑过的那个默认假设,可能有问题”。对一个领域共识里藏着的假设感到不对劲,这是研究品味,目前只有人有。
第二件,是那个有锋芒的机制洞察。
我综述里最像“想法”而不是“整理”的,是这么一句。这些研究看上去对覆盖率不敏感、结论很稳健,是因为成本和收益是同方向一起缩放的,结果就显得稳。可正因为这样,这个参数对决策真正有多大撬动,反而从来没被检验过。它稳是稳出来的假象。
这句话不只是在描述一个现象,它说清了这些作者为什么会“合理地”误以为自己的结论很稳健。外生和内生 AI 能归纳,六种类型 AI 能长出来,但看穿这帮人为什么会误判自己稳健的这一刀,是只有我贡献的那点智力增量。把这一刀磨成全文的理论核心,这篇综述就从一篇干净的描述性综述,变成一篇有观点的方法学批判,从中游期刊变成有机会冲顶级。
第三件,是裁定什么算真值。
蛋白那三篇能全自动跑通,唯一的原因是 ClinVar 这个客观金标准是天上掉下来的。AUROC 是数学,标签现成,AI 只管算。一回到系统综述,真值立刻不客观了。哪一篇算“外生处理采纳率”?某篇里 70% 的市场份额,算不算一个采纳率参数?前面那篇推断出来的“100% 覆盖”,是真的还是推的?这些判断要靠人对这个领域的理解去裁,不同的人还会有分歧,所以系统综述才要双人筛选。AI 可以给一个分类,但它没资格独自裁定这个分类就是真值。因为它的判断没法被它自己验证,它会掉进自己给自己打分的循环里。
第四件,是为整个研究的可信度背书、担责。
PROSPERO 是系统综述的一个前瞻注册库,注册的本质,是一个有身份、可追责的人,在动手之前做出公开承诺,承诺自己打算怎么做。AI 把所有检索都跑完,也注册不了这个。检索策略的同行评审,需要有那么一个“谁”站出来对策略负责。利益冲突声明,需要一个有利益、有身份的主体来声明。署名就是担责,AI 不能署名,因为它不能为结论负责。科研共同体最后接受一个结论,靠的不只是结论对不对,还靠有没有一个人站出来,为这个结论的整个生产过程负责。AI 是引擎,不是那个负责的主体。
这也是我本文的结论之一:目前AI尚无法达到严格意义上的100%自动化,原因在于AI无法为结论和整个生产过程承担任何一点责任。
最该警惕的一条
这套自动化最危险的地方,恰恰是它做得太顺、太可信。它引用规范,会标 COULD NOT VERIFY,会自我纠错,甚至驳倒我的论点。这些都让它显得极其可靠。可正是这份可靠,最容易让人放松警惕。
三个具体的雷。“四路并行等于机器一致性”读着像交叉验证,其实是四个副本在共享盲点,越一致越骗人。“30 篇全是外生”这个结论干净得让人警惕地高兴,一个发现完美支撑你想说的话时,得回头问一句,是不是那张抽取表的设计,自己把模糊案例都同向归了类。付费墙的偏倚还没解决,可我现在写阶段性结论时的语气,已经在用“N 等于 30 撑着”这种接近定稿的措辞了,在代表性立住之前,这份自信是超前的。
把这三个雷放一起看,是同一件事。AI 给的东西看起来可靠,和这东西经过了人的核验、是真值,这两者之间有一道缝。这道缝,是唯一不能外包出去的工作。
关于这篇综述,三个判断
有没有结论?有,清晰、精确、很可能是对的。但它现在是一个有充分理由相信、却还没被严格证立的强假说,不是一篇系统综述的已证立结论。结论本身对,可支撑它的证据基座还不合法,单库、单人、只有开放获取那部分。
原创吗?原创,但是站在 Dalton 2025 肩膀上的原创。作为一个发现,它是真原创,把采纳率当成分析对象,此前没人做过,我查重坐实了。作为一个研究设计,它是应用型原创,Dalton 在肥胖领域已经用过“拿单个参数横扫整个经济评价”这套做法,我把它迁到了我研究的采纳率上。投稿的时候,我必须主动、显眼地引用 Dalton 2025,说清楚本研究是把他的做法用到了采纳率上。主动承认是成熟,被审稿人发现你没提,才会被质疑你在掩盖自己不够原创。这篇最值钱的原创,不在“我查了 30 篇发现全是外生”,在前面那个机制洞察。
能投了吗?还不能。卡在三个硬门槛上,多库检索得补 Embase、EconLit、WoS,双人筛选得做,付费墙后那 15 篇得补全,PROSPERO 得注册。补完这些,结论内容很可能不变,但到那时候,它才真正成立。
写在最后
整套跑下来,结论很清楚。AI 让“做完科研”这件事变容易了,却让“做对科研”里头人的那部分判断,变得比以前更稀缺、更值钱。人的价值正在往上挪,从“会跑实验、会写论文”这一头,挪到“会提对的问题、会裁定什么算真值、能为结论负责”那一头。前一头 AI 已经追平甚至超过,后一头它还差得远。
我拿这四篇真正练出来的,不是会跑 ESM-2。是设计一个站得住的比较。先在有现成真值的蛋白领域把整套流程跑干净,再搬回没有真值的卫生经济主场,让 AI 的边界在这一来一回里自己显出来。是在一个领域所有人都不质疑的默认假设上,看出那里其实有问题。这两件事,到今天为止,还得人来做。
以上文章,由Claude Opus4.8撰写;蛋白质的科研论文由AI最严厉的父亲撰写,Roland完成审稿工作。
关于作者
Roland Wayne,医学与经济学全奖博士,《中国企业 AI 转型白皮书》作者,Google 全栈 AI|Anthropic AI 教育 / 教学架构 认证专家。
持续分享 AI 跨界实践、认知升级、第一性思考。